AI local pe laptop și telefon: de ce companiile mută din nou procesarea din cloud pe dispozitive?

' fill='%23FBBC05' d='M0 37V11l17 13z'/%3e%3cpath clip-path='url(%23b)' fill='%23EA4335' d='M0 11l17 13 7-6.1L48 14V0H0z'/%3e%3cpath clip-path='url(%23b)' fill='%2334A853' d='M0 37l30-23 7.9 1L48 0v48H0z'/%3e%3cpath clip-path='url(%23b)' fill='%234285F4' d='M48 48L17 24l-4-3 35-10z'/%3e%3c/svg%3e)
Într-o dimineață obișnuită la birou, un angajat deschide un contract, cere un rezumat și primește răspunsul înainte să apuce să se gândească unde a ajuns documentul. Gestul durează câteva secunde, însă în spatele lui se află o întrebare pe care companiile încep să o trateze mult mai serios: era nevoie ca toate acele informații să plece de pe calculator? Pentru o schiță de prezentare, răspunsul poate părea lipsit de importanță. Pentru un contract confidențial, o ofertă comercială sau o discuție despre salarii, traseul datelor schimbă întreaga evaluare.
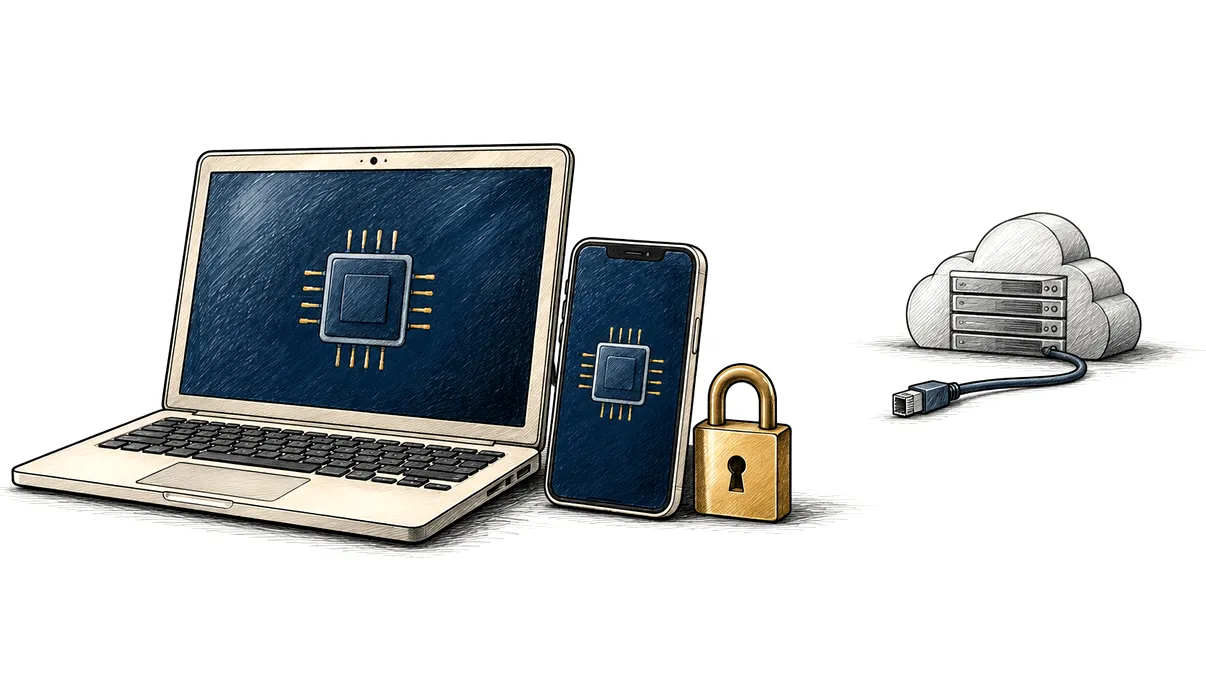
Procesarea locală readuce această întrebare aproape de utilizator. Un model AI poate genera text, identifica informații sau interpreta anumite imagini folosind resursele laptopului ori ale telefonului, fără să trimită obligatoriu fiecare cerere către un centru de date. Direcția se vede în platformele marilor producători, dar interesul companiilor are și o explicație foarte practică: costurile recurente, întârzierile și regulile de acces devin mai greu de gestionat atunci când inteligența artificială intră în aproape fiecare operațiune. Revenirea către dispozitive înseamnă, de fapt, o nouă împărțire a muncii între acestea și infrastructura centrală.
Ce se mută pe dispozitiv și ce rămâne în infrastructura centrală
Prima distincție utilă este între antrenarea unui model și utilizarea lui. Antrenarea construiește sau modifică parametrii prin care sistemul învață regularități din date; inferența este etapa în care modelul deja pregătit produce un rezultat. Când o companie spune că rulează AI pe laptop, de cele mai multe ori se referă la inferență. Angajatul primește un model creat în altă parte, pe care dispozitivul îl execută pentru sarcini concrete. Unele adaptări locale sunt posibile, însă nu trebuie confundate cu antrenarea de la zero a unui model foarte mare.
Această separare explică de ce AI local nu presupune abandonarea cloudului. Un telefon poate transcrie o notiță, poate organiza informații sau poate efectua o prelucrare preliminară, în timp ce o analiză amplă, care combină multe documente și instrumente, este trimisă către un serviciu mai puternic. Arhitectura poate decide și să păstreze integral anumite operațiuni în rețeaua companiei. Important este să existe o regulă explicită pentru fiecare traseu, astfel încât eticheta „local” să descrie ceea ce se întâmplă efectiv cu cererea.
Apple a prezentat în iunie 2026 o familie de modele care include atât variante pentru dispozitive, cât și modele pentru Private Cloud Compute. Exemplul arată că însăși platforma este gândită ca un ansamblu cu mai multe niveluri de procesare. Existența unor modele locale mai capabile nu elimină rolul serverelor, iar disponibilitatea unei funcții depinde de dispozitiv, software și condițiile de utilizare. Pentru o companie, concluzia utilă este posibilitatea de a distribui sarcinile, nu presupunerea că orice asistent funcționează complet offline.
O direcție asemănătoare apare în browser. În anunțul din iunie 2026 despre Edge, Microsoft descrie modele și interfețe pentru procesare pe dispozitiv, inclusiv detectarea limbii și traducere, alături de funcții aflate în etape experimentale. Faptul că asemenea operațiuni pot fi integrate în browser contează pentru aplicațiile de serviciu: utilizatorul nu trebuie să deschidă un program separat pentru fiecare funcție. Totuși, integrarea unui model local într-o pagină nu împiedică pagina respectivă să trimită alte date prin mecanismele sale obișnuite.
Confidențialitatea depinde de întregul traseu al informației
Motivul cel mai ușor de înțeles pentru procesarea locală este reducerea transferurilor. Dacă rezumatul unui document este generat pe calculator, conținutul poate rămâne într-un mediu pe care organizația îl administrează direct. Pentru o firmă de inginerie din Brașov sau un cabinet de consultanță din București, această posibilitate poate simplifica discuțiile despre secrete comerciale și accesul furnizorilor. Beneficiul trebuie însă verificat în aplicația folosită, deoarece modelul, interfața, jurnalizarea și sincronizarea sunt componente diferite ale aceluiași serviciu.
Un program poate rula inferența local și, în același timp, poate trimite telemetrie, rapoarte de eroare sau copii ale istoricului către un server. Un dosar poate ajunge într-un director sincronizat automat, iar o extensie de browser poate citi rezultatul. De aceea, promisiunea că „datele nu pleacă” are nevoie de o definiție concretă: ce date, în ce etapă și prin ce componente? Dacă administrezi implementarea, verifică separat cererile către model, mecanismele de diagnostic, copiile de siguranță și accesul celorlalte aplicații.
Există și o mutare a responsabilității. Datele păstrate pe laptop trebuie protejate împotriva pierderii dispozitivului, a unui cont compromis și a accesului neautorizat din interior. Criptarea discului, actualizările, politicile pentru conturi și posibilitatea revocării accesului rămân importante. Procesarea locală reduce anumite expuneri, dar poate concentra informații sensibile pe un echipament care călătorește zilnic între birou, casă și tren. Avantajul de confidențialitate trebuie însoțit de o administrare pe măsură.
Un alt detaliu privește documentele consultate de asistent. Dacă acesta poate căuta în fișierele companiei, trebuie să respecte drepturile utilizatorului, indiferent unde rulează modelul. Un angajat nu ar trebui să primească printr-un rezumat informații pe care nu le putea deschide direct. Pentru organizație, acesta este un test mai relevant decât simpla locație a procesării: dacă sistemul citește prea mult, o arhitectură locală nu corectează problema permisiunilor și nici nu face justificată folosirea datelor respective.
Memoria, autonomia și costul real pot schimba calculul
Partea mai puțin spectaculoasă a AI local este că resursele trebuie furnizate de dispozitiv. Modelul ocupă spațiu pe stocare și memorie în timpul execuției, iar conversațiile lungi sau documentele ample solicită resurse suplimentare. Memoria necesară nu se reduce la dimensiunea fișierului descărcat. Sistemul păstrează și informații intermediare, în timp ce browserul, aplicațiile de birou și sistemul de operare continuă să funcționeze. Un test făcut pe un laptop liber poate arăta foarte diferit de aceeași sarcină rulată în mijlocul unei zile aglomerate.
GPU-ul și NPU-ul pot accelera anumite operațiuni, dacă aplicația și modelul sunt compatibile cu ele. Totuși, o valoare mare prezentată în materiale comerciale nu stabilește singură viteza asistentului. Contează memoria disponibilă, transferul datelor, implementarea software și tipul sarcinii. În exemplul Edge, Microsoft leagă explicit extinderea accesului de modele mai eficiente și de posibilitatea execuției pe CPU, inclusiv pe sisteme fără un GPU adecvat. Prin urmare, alegerea tehnologiei influențează direct câte dispozitive existente pot fi folosite.
Pe telefon, autonomia și temperatura introduc alte limite. O funcție utilizată ocazional poate avea un impact acceptabil, în timp ce generarea continuă, în paralel cu navigația și comunicațiile, schimbă consumul și confortul. Nici viteza nu este constantă în toate condițiile. Dacă pregătești o aplicație pentru echipe de teren, testează pe baterie, cu dispozitivul încălzit și cu celelalte aplicații deschise. Un rezultat rapid obținut lângă încărcător nu descrie neapărat experiența unui coleg aflat de câteva ore la un client.
Dispare factura pentru fiecare apel către un API extern doar pentru operațiunile executate efectiv local. Rămân însă costurile echipamentelor, ale distribuției modelelor, ale suportului și ale validării. O firmă cu multe cereri repetitive poate găsi economii importante; una cu utilizare rară poate plăti prea mult pentru o flotă dimensionată exagerat. Comparația corectă pornește de la costul unui rezultat utilizabil, incluzând timpul de verificare. Un răspuns gratuit ca apel, dar corectat zece minute de un specialist, are tot un cost pentru companie.
Cum poate o companie să aleagă o combinație care funcționează
Merită luat în calcul și momentul în care răspunsul este necesar. Un tehnician aflat într-o hală cu semnal slab poate avea nevoie imediat de o instrucțiune dintr-un manual aprobat, în timp ce un raport pregătit pentru săptămâna următoare poate aștepta o procesare centralizată. Sunt nevoi diferite, chiar dacă ambele sunt prezentate drept „asistență AI”. Dacă pornești de la situațiile reale ale colegilor, poți separa funcțiile pentru care independența față de rețea este esențială de cele pentru care contează mai mult capacitatea de analiză. Astfel, investiția răspunde unui mod concret de lucru și poate fi evaluată prin rezultate observabile.
O implementare rezonabilă începe cu o sarcină suficient de clară încât rezultatul să poată fi evaluat. De exemplu, o echipă ar putea testa clasificarea documentelor interne sau extragerea unor câmpuri din formulare, înainte de a oferi asistentului acces la întreaga activitate. Într-un asemenea proiect, urmărește atât cazurile reușite, cât și documentele neobișnuite, fișierele incomplete și solicitările în română. Limba, terminologia companiei și calitatea documentelor pot conta mai mult decât diferența dintre două scoruri generale de performanță.
Funcționarea offline trebuie verificată separat. Unele aplicații au nevoie de o descărcare inițială, de autentificare periodică sau de servicii externe pentru instrumente auxiliare. Documentația Apple pentru cadrul Foundation Models descrie accesul la modelul de pe dispozitiv și utilizarea offline, cu verificarea disponibilității pe sistemele compatibile. Aceasta este o capabilitate a cadrului, nu o garanție că orice aplicație construită peste el își execută local toate funcțiile. Pentru utilizator, diferența devine vizibilă abia când conexiunea lipsește.
Administrarea înseamnă și posibilitatea de a actualiza sau retrage un model. Dacă aceeași aplicație folosește versiuni diferite pe sute de laptopuri, rezultatele pot varia, iar investigarea unei erori devine mai dificilă. O politică de distribuție, o evidență a versiunilor și un set comun de teste ajută la păstrarea controlului. La fel de important este ca angajatul să înțeleagă când cererea părăsește dispozitivul, mai ales dacă aplicația trece automat la un serviciu extern în fața unei sarcini dificile.
Pentru multe companii, arhitectura potrivită va combina dispozitivele, serverele proprii și servicii externe aprobate. Lucrările simple pot rămâne aproape de utilizator, iar cele care cer mai multă capacitate pot urma un traseu separat, cu reguli clare. Sensul acestei schimbări se vede în liniștea cu care un angajat poate folosi instrumentul: știe ce îi poate cere, ce informații poate introduce și ce se întâmplă mai departe. Puterea de calcul contează, dar încrederea se construiește atunci când procesarea devine inteligibilă și controlabilă.