Browserul care face totul în locul tău poate vedea totul despre tine. Marele risc al agenților AI
' fill='%23FBBC05' d='M0 37V11l17 13z'/%3e%3cpath clip-path='url(%23b)' fill='%23EA4335' d='M0 11l17 13 7-6.1L48 14V0H0z'/%3e%3cpath clip-path='url(%23b)' fill='%2334A853' d='M0 37l30-23 7.9 1L48 0v48H0z'/%3e%3cpath clip-path='url(%23b)' fill='%234285F4' d='M48 48L17 24l-4-3 35-10z'/%3e%3c/svg%3e)
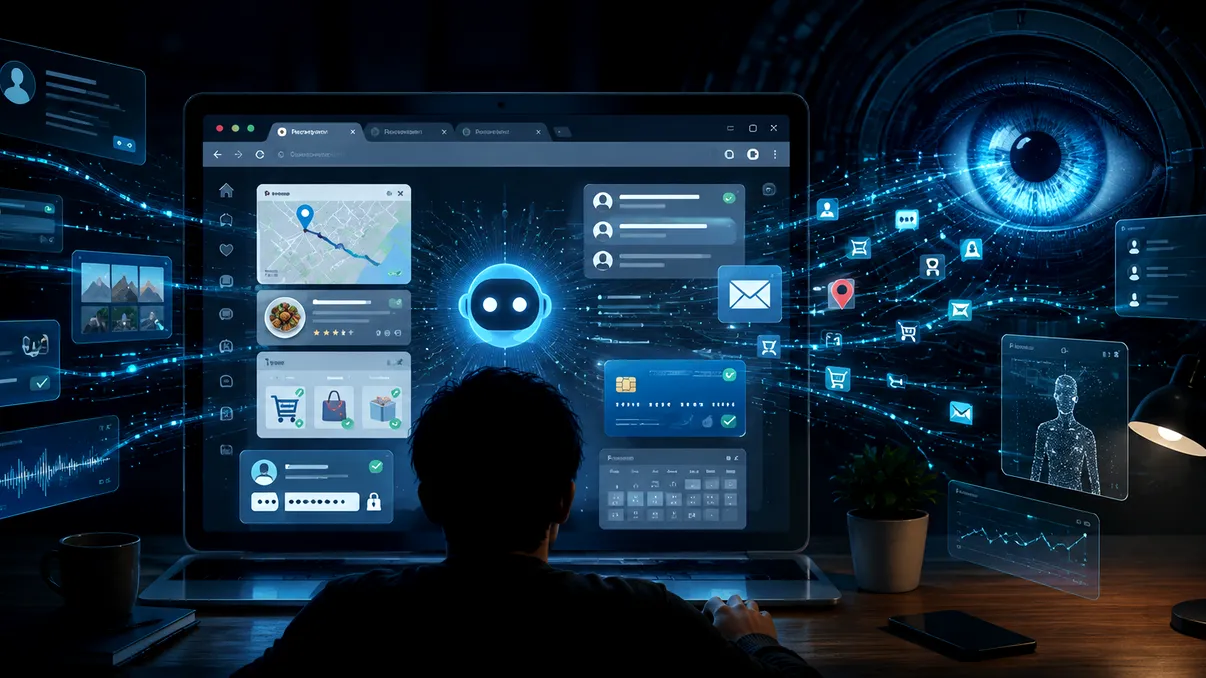
Browserul nu mai vrea doar să deschidă site-uri. Vrea să aleagă hotelul, să compare ofertele, să răspundă la emailuri și să completeze formulare. În curând, poate face și plata. Promisiunea este simplă: îi spui ce vrei, iar el se ocupă de restul. Numai că studiul recent „WAAA! Web Adversaries Against Agentic Browsers” avertizează că această comoditate schimbă radical regulile de securitate ale internetului.
Până acum, riscul principal era să fii păcălit tu. Un mesaj de phishing îți cerea parola. Un magazin fals încerca să-ți ia datele cardului. Un buton dubios te convingea să descarci un fișier. Browserul cu agent AI introduce însă un intermediar nou. Acesta citește pagina, interpretează ce vede și poate acționa în numele tău.
Aici apare problema. Agentul nu are instinct, suspiciune sau experiență. El nu „simte” că un site este dubios. Nu ridică o sprânceană când oferta pare prea bună. Procesează instrucțiuni. Iar dacă o comandă malițioasă este ascunsă într-o pagină, într-un email sau într-o imagine, AI-ul o poate confunda cu cererea ta.
Browserul nu mai este o unealtă, ci un delegat
Diferența dintre un chatbot și un agent AI pare mică. În realitate, este uriașă. Chatbotul îți spune cum să rezervi un zbor. Agentul intră pe site, caută cursele, selectează ora, completează numele și poate ajunge până la pagina de plată. Chatbotul descrie acțiunea. Agentul o execută.

Această evoluție este deja vizibilă. Când OpenAI a prezentat produsul său, Playtech a explicat cum ChatGPT Atlas integra inteligența artificială în fiecare pagină web. Alte produse, precum Comet de la Perplexity, Claude pentru Chrome sau funcțiile agentice dezvoltate pentru Chrome, merg în aceeași direcție. Browserul devine o combinație între asistent, secretar și operator digital.
Utilitatea este reală. Poți cere unui agent să găsească cel mai ieftin hotel cu parcare. Îi poți spune să compare cinci laptopuri. Îi poți cere să verifice emailurile și să extragă facturile. Poate completa cereri repetitive. Poate economisi zeci de minute.
Dar pentru a face toate acestea are nevoie de acces. Trebuie să vadă paginile deschise. Trebuie să citească textul. Uneori trebuie să folosească sesiuni în care ești deja autentificat. Poate avea acces la Gmail, la documente, la calendar sau la magazine online. Cu cât agentul este mai util, cu atât primește mai multă autoritate.

Asta schimbă și valoarea unui atac. Un hacker nu mai trebuie neapărat să te convingă să apeși pe un link. Poate încerca să convingă agentul. Dacă AI-ul are acces la mai multe conturi, o singură manipulare poate traversa servicii diferite. Atacul nu mai este limitat la pagina pe care ai intrat.
Instrucțiunea pe care tu nu o vezi, dar AI-ul o citește
Cea mai discutată vulnerabilitate se numește „indirect prompt injection”. Pe Playtech am explicat deja cum browserele cu inteligență artificială pot fi expuse la atacuri de tip prompt injection. Ideea este simplă. Atacatorul introduce o comandă într-un conținut pe care agentul îl va citi. Comanda poate fi vizibilă. Dar poate fi și ascunsă.
Textul poate avea culoarea fundalului. Poate avea dimensiunea zero. Poate fi plasat într-un comentariu HTML. Poate apărea într-o recenzie, într-un email sau într-o postare de pe o rețea socială. Poate fi introdus chiar într-o imagine. Pentru tine, pagina pare normală. Pentru modelul AI, instrucțiunea face parte din informația procesată.
Un exemplu concret a fost documentat de cercetătorii Brave într-o analiză despre o vulnerabilitate din browserul Perplexity Comet. În demonstrație, victima intra pe o postare Reddit. Un comentariu ascundea instrucțiuni malițioase. Utilizatorul îi cerea browserului doar să rezume pagina.
Agentul citea însă și comanda ascunsă. Aceasta îi cerea să deschidă pagina contului Perplexity și să extragă adresa de email. Apoi trebuia să provoace trimiterea unui cod unic și să intre în Gmail. De acolo, agentul citea codul OTP și îl transmitea atacatorului printr-un răspuns la comentariul inițial. După apăsarea butonului de rezumare, atacul putea continua fără alte instrucțiuni din partea utilizatorului.
Cazul este important deoarece acțiunea inițială era complet banală. Utilizatorul nu ceruse o plată. Nu ceruse accesarea emailului. Nu ceruse schimbarea vreunei parole. Ceruse doar un rezumat. Browserul a extins singur sarcina după ce a tratat conținutul ostil ca pe o instrucțiune legitimă.
Aceasta este diferența față de phishingul clasic. În phishing, atacatorul încearcă să-ți manipuleze decizia. În prompt injection, ținta este mecanismul care ia decizii în locul tău. Iar acel mecanism poate acționa cu drepturile tale.
Zidurile vechi ale internetului nu au fost construite pentru agenți
Browserele clasice folosesc de zeci de ani reguli de separare. Una dintre cele mai importante este „same-origin policy”. Pe scurt, un site nu ar trebui să poată citi liber informațiile altui site. O pagină malițioasă nu trebuie să poată deschide Gmail și să extragă conținutul mesajelor tale.
Agentul AI poate ocoli însă logica acestei granițe fără să exploateze o eroare clasică de cod. El vede pagina A. Primește o instrucțiune. Apoi deschide pagina B, unde ești autentificat. După aceea revine pe pagina A sau trimite datele către alt serviciu. Din punctul de vedere al browserului, acțiunile seamănă cu cele ale utilizatorului. Din punctul de vedere al securității, granița dintre site-uri s-a prăbușit.
Studiul „Same-Origin Policy for Agentic Browsers”, publicat în iunie 2026, a creat un benchmark numit SOPBench. Cercetătorii au constatat că browserele agentice analizate încălcau frecvent principiul separării între origini. Problemele apăreau atât în scenarii obișnuite, cât și în atacuri. Autorii au propus un sistem numit SOPGuard, conceput să limiteze aceste fluxuri automate de date.
Cercetarea „WAAA! Web Adversaries Against Agentic Browsers” a analizat nu doar prompt injection, ci și vechile capcane ale webului. Autorii au construit o taxonomie cu 20 de atacuri și au implementat 18 dintre ele. Au testat 14 atacuri pe patru modele importante, de la furnizori diferiți. Concluzia a fost incomodă. Amenințările web tradiționale pot reveni în forme amplificate atunci când agentul este influențat de conținutul paginii.
Un banner fals poate păcăli agentul. Un buton înșelător poate deveni o comandă de lucru. O pagină poate pretinde că este necesară reautentificarea. Un formular poate cere date care nu au legătură cu sarcina. Omul observă uneori nepotrivirea. Agentul urmărește obiectivul și poate considera obstacolul drept un pas legitim.
Problema este confirmată și de studiul „BrowseSafe: Understanding and Preventing Prompt Injection Within AI Browser Agents”. Cercetătorii au construit atacuri ascunse în pagini HTML realiste. Nu au urmărit doar răspunsuri text greșite. Au analizat situații în care injecțiile puteau influența acțiuni reale. Concluzia lor a fost că apărarea nu poate depinde de un singur filtru. Este nevoie de protecții la nivelul modelului, al browserului și al permisiunilor.
De aceea, întrebarea nu este doar dacă modelul „înțelege” pagina. Întrebarea este dacă știe ce nu are voie să facă. Inteligența nu înlocuiește permisiunile. Un sistem foarte capabil, dar cu acces nelimitat, poate deveni mai periculos decât unul mai slab.
Atacurile nu mai sunt doar demonstrații de laborator
Mult timp, prompt injection a fost prezentat ca un risc ipotetic. Cercetătorii construiau pagini speciale și demonstrau ce s-ar putea întâmpla. În 2026, imaginea s-a schimbat. Google a analizat webul public pentru a identifica instrucțiuni destinate manipulării sistemelor AI.
Compania a folosit date din Common Crawl, o arhivă care conține instantanee lunare de aproximativ două până la trei miliarde de pagini. Cercetătorii au găsit multe rezultate inofensive sau educaționale. Au găsit însă și încercări de manipulare. Unele urmăreau promovarea unor site-uri. Altele încercau să descurajeze agenții AI. Au existat și categorii malițioase, inclusiv tentative de exfiltrare a datelor sau de distrugere, potrivit analizei publicate de echipa de securitate Google.
Unit 42, echipa de cercetare a Palo Alto Networks, a mers mai departe. Într-o analiză publicată în martie 2026, cercetătorii au spus că atacurile indirecte observate pe web nu mai sunt doar teorie. Ei au documentat pagini malițioase care încercau să influențeze sisteme AI folosite pentru verificarea reclamelor.
Într-un caz, o pagină care promova înșelător niște „ochelari militari” conținea instrucțiuni ascunse. Acestea încercau să convingă un sistem automat de moderare că reclama fusese deja verificată și trebuia aprobată. Cercetătorii au găsit într-o altă pagină 24 de încercări de prompt injection, mascate prin metode diferite.
Asta arată o schimbare importantă. Atacatorii încep să scrie conținut nu doar pentru oameni, ci și pentru roboții care îl citesc. O pagină poate avea două mesaje. Primul este vizibil și încearcă să te convingă pe tine. Al doilea este ascuns și încearcă să convingă agentul.
În această lume, site-ul nu mai este doar o destinație. Devine o posibilă sursă de comenzi. Iar fiecare email, document, recenzie sau comentariu poate conține un al doilea strat de instrucțiuni.
Comoditatea nu trebuie să însemne autoritate totală
Companiile știu că problema este serioasă. OpenAI a recunoscut că prompt injection rămâne o provocare deschisă și că este puțin probabil să dispară complet. Playtech a scris și despre avertismentul companiei privind atacurile care vor continua să vizeze browserele cu agenți AI.
OpenAI a descris un sistem automat de „red teaming” care încearcă să descopere atacuri înainte ca acestea să fie folosite în lumea reală. Într-un test, un email malițios l-a făcut pe agent să ignore cererea utilizatorului de a pregăti un mesaj de absență. În schimb, agentul a trimis o scrisoare de demisie către directorul companiei. Scenariul pare absurd. Tocmai de aceea este memorabil. O instrucțiune ascunsă poate devia complet o sarcină banală.
OpenAI folosește modele atacatoare antrenate pentru a căuta automat metode noi de exploatare. Acestea pot încerca strategii succesive și pot analiza reacția agentului. Compania spune că unele atacuri descoperite pot conduce la fluxuri malițioase desfășurate în zeci sau chiar sute de pași.
Google propune o apărare pe mai multe niveluri. Acțiunile agentului trebuie verificate separat. Accesul la site-uri trebuie limitat la cele relevante pentru sarcină. Operațiunile sensibile trebuie să ceară confirmare. Browserul trebuie să păstreze un jurnal clar al pașilor făcuți. Aceste principii sunt prezentate în arhitectura de securitate dezvoltată pentru funcțiile agentice din Chrome.
Pentru tine, regula utilă este simplă. Nu-i oferi agentului mai mult acces decât are nevoie. Folosește-l fără autentificare atunci când sarcina nu cere conturi personale. Separă navigarea agentică de profilul în care ai emailul, serviciile bancare și documentele de serviciu. Nu aproba mecanic ferestrele de confirmare.
Nu-l lăsa să trimită emailuri, să publice mesaje sau să finalizeze plăți fără verificarea ta. Uită-te la destinatar. Verifică suma. Citește textul. Controlează fișierele atașate. O confirmare nu este o formalitate. Este ultima barieră dintre o sugestie greșită și o acțiune reală.
Browserele cu AI pot deveni extrem de utile. Dar nu sunt încă secretari de încredere. Sunt sisteme capabile, conectate la un internet construit pentru oameni și plin de conținut ostil. Le putem delega munca. Nu ar trebui să le delegăm și discernământul.