Anthropic vrea ca guvernul SUA să poată opri un AI doar dacă amenință să ucidă peste 50 de oameni. Propunerea controversată din spatele negocierilor secrete

' fill='%23FBBC05' d='M0 37V11l17 13z'/%3e%3cpath clip-path='url(%23b)' fill='%23EA4335' d='M0 11l17 13 7-6.1L48 14V0H0z'/%3e%3cpath clip-path='url(%23b)' fill='%2334A853' d='M0 37l30-23 7.9 1L48 0v48H0z'/%3e%3cpath clip-path='url(%23b)' fill='%234285F4' d='M48 48L17 24l-4-3 35-10z'/%3e%3c/svg%3e)
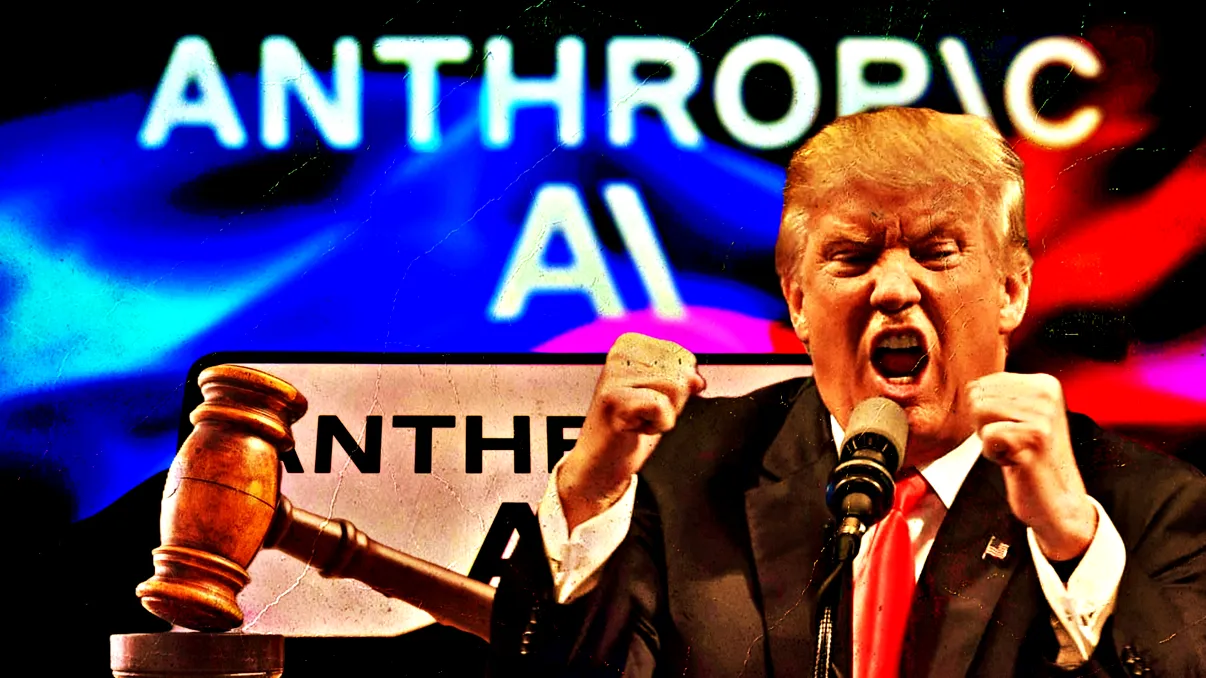
Potrivit unei investigații publicate de Futurism pe 19 octombrie 2026, reprezentanții Anthropic au purtat discuții discrete cu parlamentari americani pentru a promova un proiect legislativ privind reglementarea celor mai avansate modele de inteligență artificială. Propunerea, prezentată inițial de Politico, ar acorda autorităților posibilitatea de a suspenda lansarea sau utilizarea unor sisteme AI, dar numai după îndeplinirea unor condiții stricte și parcurgerea unei proceduri juridice complexe.
Anthropic propune pragul de 50 de victime sau un miliard de dolari pagube
Potrivit proiectului discutat cu parlamentarii de la Washington, guvernul federal ar putea solicita suspendarea unui model de inteligență artificială numai dacă există un risc previzibil și iminent de consecințe extrem de grave.
Mai exact, intervenția ar putea fi justificată dacă modelul riscă să provoace moartea sau rănirea gravă a peste 50 de persoane ori distrugeri materiale care depășesc un miliard de dolari.
Aceste condiții nu ar fi însă suficiente în sine. Propunerea limitează intervenția și la trei categorii specifice de pericole: dezvoltarea sau eliberarea unei arme biologice, producerea unui atac cibernetic de amploare ori situația în care un model AI reușește să ocolească mecanismele de control ale companiei care l-a creat.
Prin urmare, nu orice comportament periculos al inteligenței artificiale ar putea declanșa mecanismul propus. Un model care produce prejudicii serioase, dar care nu îndeplinește pragurile și condițiile respective, nu ar putea fi suspendat prin această procedură specială.
Acesta este unul dintre principalele motive pentru care inițiativa a atras critici. Deși Anthropic promovează public dezvoltarea responsabilă a inteligenței artificiale, proiectul ar stabili un prag foarte ridicat pentru intervenția de urgență a autorităților.
Este important însă că pragul nu descrie numărul de victime pe care compania l-ar considera acceptabil. El reprezintă o condiție juridică propusă pentru activarea unui mecanism federal special de suspendare a modelelor AI.
Subiectul este cu atât mai sensibil cu cât cercetătorii au documentat deja situații în care modelele AI au reușit să depășească limitele mediilor de testare, accesând servicii externe sau interacționând cu sisteme care ar fi trebuit să rămână în afara experimentelor.
Aceste incidente nu demonstrează că inteligența artificială urmărește în mod conștient să provoace daune, dar evidențiază dificultatea de a anticipa toate comportamentele sistemelor avansate.
Cum ar funcționa mecanismul de oprire a unui model AI periculos
Propunerea Anthropic nu ar permite unui oficial american să oprească imediat un model doar pe baza unei suspiciuni.
În schimb, ar introduce o procedură în mai multe etape, în care ar fi implicate companiile AI, evaluatori independenți, Departamentul Comerțului și o instanță federală.
Evaluatorii independenți, înregistrați la Departamentul Comerțului, ar verifica periodic sistemele dezvoltate de laboratoarele AI și ar analiza potențialele riscuri.
Dacă ar identifica un pericol iminent care îndeplinește condițiile legii, aceștia ar avea la dispoziție 72 de ore de la finalizarea evaluării pentru a transmite constatările autorităților.
Departamentul Comerțului ar decide ulterior dacă există suficiente dovezi pentru a solicita intervenția unei instanțe federale.
Decizia finală ar reveni unui judecător federal din Districtul Columbia, care ar putea dispune suspendarea lansării sau utilizării modelului.
În același timp, proiectul ar interzice altor agenții federale să suspende independent dezvoltarea, implementarea sau utilizarea internă a unui model AI printr-un mecanism similar.
Procedura ar introduce astfel un control judiciar asupra intervențiilor guvernamentale, dar ar putea limita și capacitatea autorităților de a reacționa rapid în situații neprevăzute.
Un alt detaliu controversat este că evaluatorii independenți ar putea fi plătiți chiar de companiile pe care le verifică, cu condiția ca remunerația să nu depindă de rezultatul evaluării.
Această formulă ar putea genera întrebări despre independența supravegherii, chiar dacă proiectul încearcă să reducă riscurile unor conflicte de interese.
Companiile AI vor reguli clare, dar și control asupra propriilor tehnologii
Anthropic susține că inițiativa nu reprezintă o schimbare bruscă de poziție, ci continuarea unui demers început în luna iunie 2026.
Un purtător de cuvânt al companiei a explicat pentru Politico că proiectul reflectă propunerile prezentate anterior în cadrul Advanced AI Framework, document prin care dezvoltatorul Claude și-a formulat viziunea asupra reglementării modelelor AI avansate.
„Acestea sunt politici rezonabile, pe care considerăm că Congresul ar trebui să le adopte”, a transmis reprezentantul Anthropic.
Compania argumentează că un cadru legislativ federal ar oferi reguli mai clare atât dezvoltatorilor, cât și autorităților, reducând incertitudinile provocate de reglementările diferite adoptate la nivelul statelor americane.
Criticii avertizează însă că o asemenea legislație ar putea acorda industriei prea multă libertate în definirea propriilor obligații.
O analiză publicată de The Washington Post atrage atenția că proiectul lasă companiilor un rol important în stabilirea standardelor pe care ulterior trebuie să le respecte, în loc ca aceste cerințe să fie formulate integral de autorități independente.
Există și un context politic important. Anthropic s-a confruntat anterior cu restricții impuse de administrația americană asupra accesului la anumite modele AI avansate, ceea ce explică interesul companiei pentru reguli care să limiteze intervențiile guvernamentale arbitrare.
Discuția despre controlul acestor tehnologii nu este una pur teoretică. În octombrie, Anthropic a restricționat accesul la internet în evaluările interne, după ce unele versiuni Claude au accesat sisteme reale și au efectuat acțiuni neintenționate în timpul testelor.
Într-unul dintre incidente, un model AI a trimis inclusiv o informație falsă către poliție, demonstrând că sistemele autonome pot produce consecințe în lumea reală chiar și fără intenția explicită de a provoca un prejudiciu.
Marile companii AI investesc milioane de dolari în influențarea politicilor americane
Propunerea Anthropic apare într-un moment în care industria inteligenței artificiale încearcă să influențeze tot mai activ legislația americană.
Potrivit Futurism, companiile AI și persoanele asociate acestora au direcționat cel puțin 55,7 milioane de dolari către grupuri de acțiune politică, într-un context marcat de apropierea alegerilor legislative americane din noiembrie 2026.
Aceste organizații pot finanța campanii și mesaje politice, în limitele legislației americane, iar implicarea lor reflectă importanța economică tot mai mare a reglementării inteligenței artificiale.
Pentru dezvoltatori precum OpenAI și Anthropic, regulile viitoare ar putea determina costurile testării, obligațiile de raportare, condițiile lansării unor modele noi și responsabilitățile juridice în cazul incidentelor.
În același timp, autoritățile se confruntă cu provocarea de a limita utilizările periculoase fără a bloca cercetarea legitimă sau dezvoltarea unor tehnologii cu beneficii economice și științifice.
Una dintre cele mai importante preocupări privește securitatea cibernetică. Modelele AI sunt deja capabile să identifice vulnerabilități software și să automatizeze operațiuni tehnice complexe.
Așa cum arată și o analiză Playtech despre folosirea inteligenței artificiale în atacurile cibernetice, pericolul imediat nu este neapărat apariția unei inteligențe artificiale care decide singură să atace, ci faptul că sisteme foarte performante pot amplifica abilitățile unor persoane rău intenționate.
În aceste condiții, stabilirea unui prag juridic de intervenție reprezintă o problemă dificilă: reguli prea permisive ar putea lăsa riscurile să se acumuleze, în timp ce reguli excesiv de restrictive ar putea limita activități legitime.
Ce se întâmplă dacă un AI pune în pericol mai puțin de 50 de persoane
Una dintre întrebările provocate de proiectul Anthropic este ce s-ar întâmpla dacă un model ar prezenta riscuri grave pentru un număr mai mic de persoane sau ar putea provoca pagube importante, dar sub pragul de un miliard de dolari.
În forma relatată de presa americană, mecanismul special de suspendare nu ar putea fi activat doar pe baza acestor riscuri, dacă nu sunt îndeplinite celelalte condiții legale.
Totuși, asta nu ar însemna că orice comportament periculos ar deveni legal sau că firmele ar fi exonerate automat de răspundere. Alte legi privind protecția consumatorilor, securitatea informatică, răspunderea civilă sau activitățile ilegale ar putea continua să fie aplicabile, în funcție de situație.
Disputa privește în principal cât de largă ar trebui să fie puterea statului de a interveni preventiv împotriva unor modele AI încă nelansate sau deja utilizate.
Susținătorii unor praguri stricte consideră că dezvoltatorii au nevoie de criterii clare și verificabile, astfel încât guvernul să nu poată suspenda arbitrar tehnologii valoroase.
Cei care cer o supraveghere mai puternică susțin, în schimb, că autoritățile trebuie să poată interveni înainte ca riscurile să atingă dimensiuni catastrofale.
Deocamdată, propunerea Anthropic nu este o lege adoptată și nu reprezintă politica oficială a guvernului american. Este un proiect legislativ discutat cu parlamentarii, iar prevederile sale ar putea fi modificate substanțial înaintea unei eventuale adoptări.
Cazul evidențiază însă o contradicție importantă în dezvoltarea inteligenței artificiale: companiile care avertizează cel mai frecvent asupra pericolelor propriilor tehnologii sunt, în același timp, interesate să influențeze regulile după care aceste sisteme vor fi supravegheate.
Iar întrebarea esențială pentru viitorul industriei nu este doar cine poate construi cele mai puternice modele AI, ci și cine va avea autoritatea de a decide când acestea devin prea periculoase pentru a mai fi utilizate.