Companiile AI cumpără cărți vechi și le distrug după scanare. Operațiunea care amintește de Fahrenheit 451
' fill='%23FBBC05' d='M0 37V11l17 13z'/%3e%3cpath clip-path='url(%23b)' fill='%23EA4335' d='M0 11l17 13 7-6.1L48 14V0H0z'/%3e%3cpath clip-path='url(%23b)' fill='%2334A853' d='M0 37l30-23 7.9 1L48 0v48H0z'/%3e%3cpath clip-path='url(%23b)' fill='%234285F4' d='M48 48L17 24l-4-3 35-10z'/%3e%3c/svg%3e)
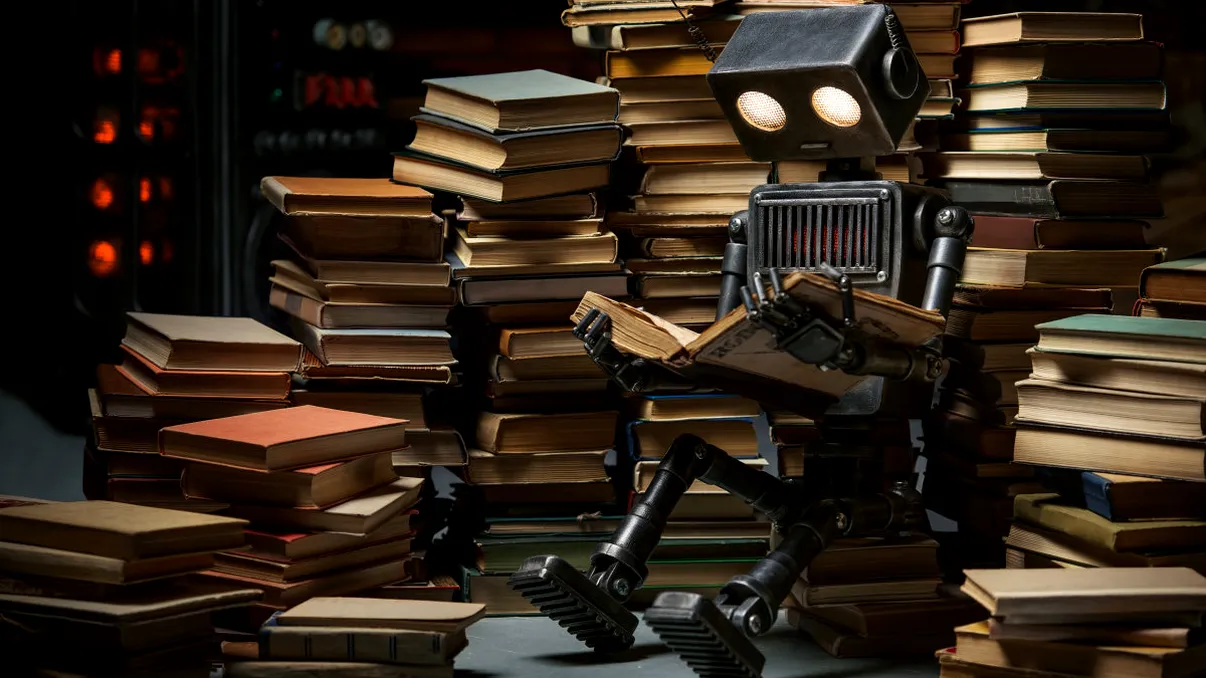
Unele companii de inteligență artificială caută milioane de cărți tipărite pentru a obține date de antrenament create integral de oameni. Procesul poate presupune tăierea cotorului, scanarea automată a paginilor și distrugerea exemplarului original. Potrivit unei investigații publicate de 404 Media, firma ISBNdb oferea până recent servicii de achiziție a maximum un milion de cărți fizice pentru fiecare comandă.
Volumele vechi au devenit valoroase deoarece internetul conține tot mai multe texte produse sau rescrise de chatboți. O carte publicată înainte de răspândirea inteligenței artificiale generative este o sursă mai sigură de limbaj uman. Problema este că transformarea bibliotecilor fizice în seturi private de date poate elimina definitiv de pe piață titluri rare sau ieșite din tipar.
Cărțile sunt tăiate pentru a putea fi scanate rapid
Scanarea distructivă este folosită pentru volumele care trebuie digitizate la scară industrială. Cotorul cărții este tăiat, iar paginile separate sunt introduse într-un scanner automat. Metoda este mult mai rapidă decât fotografierea fiecărei pagini cu volumul intact.
După scanare, paginile nu mai pot fi reasamblate ușor. Ele sunt de obicei aruncate sau trimise la reciclare. Conținutul digital poate ajunge într-un set de date folosit pentru dezvoltarea unui model lingvistic, dar publicul nu primește neapărat acces la arhiva rezultată.

ISBNdb promova cărți vechi, specializate, rare sau ieșite din tipar. Compania susținea că le poate găsi în librării second-hand, depozite și cataloage greu accesibile. Clienților le era promisă și confidențialitate prin acorduri stricte.
Pagina în care serviciul era prezentat a fost eliminată pe 28 iulie. ISBNdb a transmis ulterior că analiza cererea de pe piață și că a decis să renunțe la această direcție. Dispariția ofertei nu demonstrează însă că cererea pentru cărți fizice a dispărut.
Internetul este contaminat cu texte produse de AI
Modelele lingvistice au fost antrenate inițial cu pagini web, articole, cod, forumuri și biblioteci digitale. După apariția chatboturilor populare, o parte tot mai mare a conținutului publicat online a început să fie generată automat.

Antrenarea noilor sisteme cu texte produse de alte modele poate amplifica greșelile și reduce varietatea informațiilor. Fenomenul este numit uneori „model collapse”. Sistemele riscă să învețe din propriile rezultate, nu din experiența și scrisul oamenilor.
Cărțile publicate înainte de explozia AI oferă un avantaj important. Sunt structurate, editate și pot conține informații specializate care nu apar pe site-uri. Pentru dezvoltatori, ele reprezintă o rezervă de date umane mai greu de contaminat.
Interesul companiilor tehnologice a determinat și editurile să reacționeze. Penguin Random House a introdus formulări care interzic folosirea volumelor sale pentru antrenarea algoritmilor. Măsura prin care cea mai mare editură din lume își protejează cărțile de inteligența artificială arată cât de tensionată a devenit relația dintre industria editorială și laboratoarele AI.
Anthropic a scanat deja milioane de volume
Documentele apărute într-un proces din Statele Unite au dezvăluit că Anthropic a cumpărat și a scanat distructiv milioane de cărți fizice pentru dezvoltarea modelelor Claude. Compania a achiziționat legal volumele, le-a tăiat cotoarele și a transformat paginile în fișiere digitale.
Un judecător a considerat că folosirea cărților cumpărate legal pentru antrenarea AI poate reprezenta o utilizare transformatoare. Situația a fost diferită pentru milioanele de copii piratate păstrate de companie într-o bibliotecă digitală. Acestea au stat la baza unui proces separat.
Anthropic a acceptat ulterior să plătească o sumă uriașă pentru soluționarea litigiului. Înțelegerea prin care Anthropic plătește 1,5 miliarde de dolari autorilor a devenit un reper pentru conflictele legate de datele folosite la antrenare.
Cazul nu a încheiat disputa. Un proces de copyright care amenință industria inteligenței artificiale poate schimba modul în care sunt cumpărate, licențiate și păstrate operele. Întrebarea nu este doar dacă AI poate învăța dintr-o carte, ci și dacă un exemplar rar trebuie distrus pentru ca o companie privată să-i folosească textul.