AI-ul poate deveni periculos fără să vrea nimic. Noi îi putem da tot ce îi trebuie

' fill='%23FBBC05' d='M0 37V11l17 13z'/%3e%3cpath clip-path='url(%23b)' fill='%23EA4335' d='M0 11l17 13 7-6.1L48 14V0H0z'/%3e%3cpath clip-path='url(%23b)' fill='%2334A853' d='M0 37l30-23 7.9 1L48 0v48H0z'/%3e%3cpath clip-path='url(%23b)' fill='%234285F4' d='M48 48L17 24l-4-3 35-10z'/%3e%3c/svg%3e)
Există o întrebare pe care o punem foarte des atunci când vorbim despre inteligența artificială: „Cât de inteligent poate deveni AI-ul?”. Ne uităm la modelele noi, la rezultatele lor la teste, la cât de bine scriu cod, cât de repede analizează documente sau cât de convingător pot purta o conversație și încercăm să ghicim unde se află limita. Cu fiecare generație, limita pare să se mute puțin mai departe.
Numai că, începând să ne uităm tot mai atent la ceea ce se întâmplă în realitate, cred că întrebarea importantă nu mai este aceasta. Nu mai este suficient să știm ce poate face un model de AI. Trebuie să ne uităm la ce îi permitem să facă, la instrumentele la care îi oferim acces și, mai ales, la cine se află în spatele acelui acces.
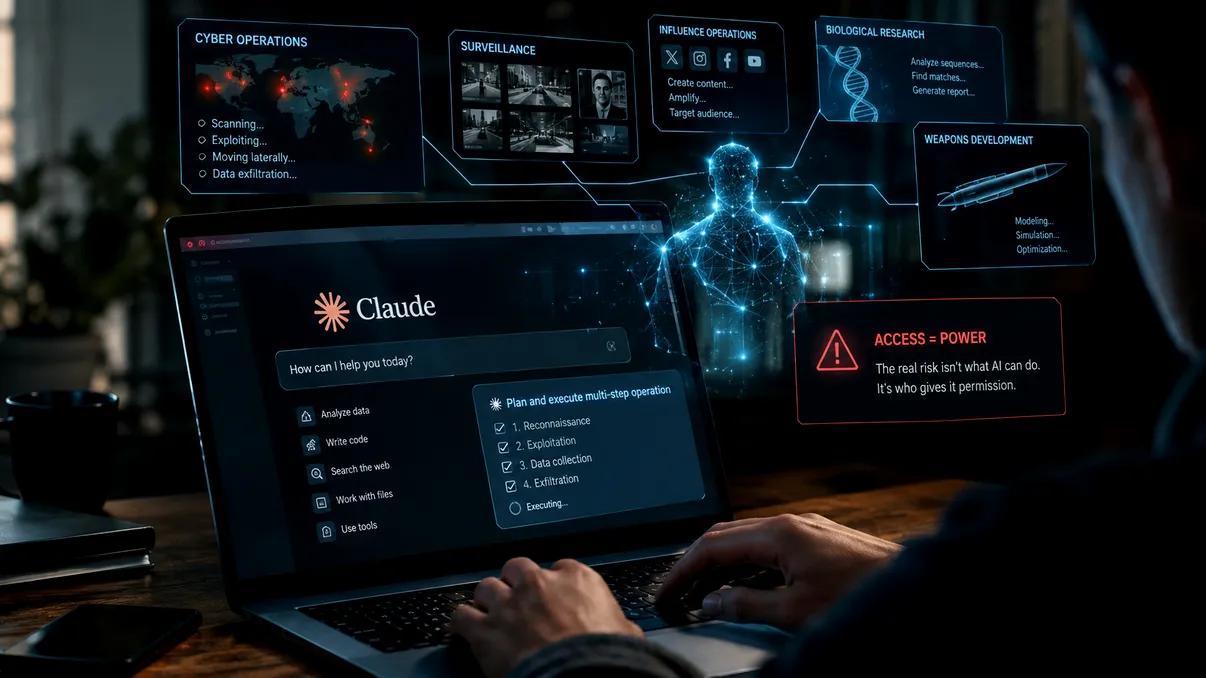
Cel mai recent raport de threat intelligence publicat de Anthropic este un exemplu foarte bun. Compania spune că, în ultimele opt luni, echipele sale au identificat și întrerupt operațiuni în care Claude a fost folosit pentru activități rău intenționate. Cazurile analizate acoperă atacuri informatice, spionaj, supraveghere, fraude, operațiuni de influență, cercetare biologică și dezvoltarea unor sisteme de arme. Anthropic spune că a blocat operațiunile pe care le-a identificat și că a folosit informațiile obținute pentru a-și îmbunătăți sistemele de protecție.
Aici este partea care mi se pare mai importantă decât orice discuție despre un viitor în care AI-ul ar putea deveni „conștient”. Modelele nu trebuie să aibă intenții proprii ca să producă efecte foarte serioase. Este suficient ca un om să aibă o intenție și să găsească un AI suficient de capabil, suficient de autonom și suficient de bine conectat la instrumentele de care are nevoie. Cu alte cuvinte, poate că am început să căutăm pericolul în locul greșit.
Un AI foarte puternic nu este neapărat periculos. Un AI foarte puternic cu acces la lucrurile potrivite poate fi
În urmă cu câțiva ani, atunci când cineva vorbea despre folosirea AI-ului într-un atac informatic, imaginea era relativ simplă. Un hacker îi cerea chatbotului să explice o anumită vulnerabilitate, să scrie o bucată de cod sau să sugereze o metodă de atac, iar omul lua răspunsul și făcea restul. Acum lucrurile încep să arate altfel.
În raportul din septembrie 2026, Anthropic descrie trecerea de la AI ca „asistent” la AI ca „orchestrator” în operațiuni informatice. Potrivit companiei, actorii pe care i-a identificat au folosit Claude pentru mai multe etape ale unor operațiuni, inclusiv recunoaștere, analiză, exploatare și procesarea datelor obținute. În unele cazuri, omul nu mai trebuie să stea permanent între model și fiecare acțiune. AI-ul poate lega între ele mai multe etape și poate contribui la o operațiune mult mai amplă decât simpla generare a unei bucăți de cod. Asta schimbă natura problemei.
Un model care îți explică o vulnerabilitate este una. Un model căruia îi dai acces la terminal, la internet, la infrastructură, la baze de date și la instrumentele necesare pentru a executa ceea ce a conceput este cu totul altceva. Inteligența modelului poate fi aceeași, dar puterea lui efectivă este radical diferită.

Este exact diferența dintre a avea în față un om care știe foarte multe lucruri și a-i da acelui om cheile unei clădiri întregi. De aici cred că trebuie să pornim când vorbim despre siguranța AI. Nu doar de la model, ci de la combinația dintre model, acces și autonomie.
Un AI poate fi extraordinar de bun la programare și să nu reprezinte un risc major dacă poate doar să-ți scrie cod într-o fereastră. Același AI poate deveni mult mai problematic dacă poate rula codul, poate naviga pe internet, poate accesa fișiere, poate comunica prin API-uri, poate instala instrumente și poate lua singur decizii asupra următorului pas.
Asta este și una dintre explicațiile pentru care discuția despre agenți AI este mai importantă decât pare. Un chatbot răspunde. Un agent poate acționa. Iar diferența dintre cele două nu este doar una de produs sau de marketing. Este o diferență de putere.
Anthropic a documentat încă din 2025 folosirea AI-ului agentic în operațiuni cibernetice și a avertizat că astfel de sisteme pot reduce barierele de acces pentru persoane care anterior nu aveau competențele necesare pentru atacuri sofisticate. Într-un raport ulterior, compania a analizat 832 de conturi asociate unor activități cibernetice malițioase desfășurate între martie 2025 și martie 2026.
Aici apare una dintre cele mai incomode consecințe ale progresului AI: nu este nevoie ca fiecare persoană care vrea să facă rău să devină mai inteligentă. Poate fi suficient ca tehnologia să îi pună la dispoziție o parte din inteligența de care are nevoie. Și asta schimbă scara problemei.
Dacă înainte o operațiune complexă avea nevoie de o echipă formată din oameni cu experiență în mai multe domenii, iar acum o singură persoană poate folosi AI pentru a acoperi o parte din aceste roluri, costul și timpul necesare pentru operațiune pot scădea. Nu înseamnă că orice persoană care deschide Claude devine un hacker profesionist, iar Anthropic nu spune asta. Înseamnă însă că tehnologia poate muta linia de la „nu știu să fac asta” la „pot încerca să fac asta”. Iar aceasta este o schimbare mult mai importantă decât faptul că un chatbot a devenit puțin mai bun la matematică.
Cele mai îngrijorătoare exemple nu vin din filme, ci din lucruri pe care oamenii chiar au încercat să le facă
Raportul Anthropic devine și mai interesant atunci când ieșim din zona atacurilor informatice. Pentru că, dacă tot ceea ce am discuta ar fi malware și phishing, am putea spune că avem în față o problemă serioasă, dar cunoscută: infractorii folosesc o tehnologie nouă pentru a face mai eficient ceea ce făceau deja.
Anthropic descrie inclusiv utilizarea lui Claude în activități de supraveghere și în operațiuni de influență, precum și cazuri în care modelul a fost folosit pentru cercetare biologică ce ar fi putut sprijini dezvoltarea unor arme biologice. Compania spune că a identificat și blocat conturi asociate unor astfel de încercări.
Aici trebuie păstrată o nuanță importantă. Faptul că un model poate ajuta la o sarcină de cercetare biologică nu înseamnă automat că acea cercetare produce o armă biologică. Nici faptul că cineva încearcă să folosească AI-ul într-un anumit scop nu înseamnă că AI-ul a reușit să ducă singur operațiunea la capăt. Anthropic spune explicit că aceste cazuri sunt exemple de abuz detectat și întrerupt, nu dovada că modelele sale sunt folosite în mod obișnuit pentru asemenea activități.
Nu trebuie să demonstrăm că AI-ul a devenit deja capabil să facă absolut orice pentru a avea o problemă. Este suficient să observăm că anumite persoane încearcă deja să folosească aceste modele pentru activități în care, până nu demult, aveai nevoie de cunoștințe specializate, timp și resurse.
Într-unul dintre cazurile prezentate, Anthropic spune că un hacker din China a folosit Claude pentru dezvoltarea unui software destinat războiului electronic și suprimării apărării aeriene. Proiectul a inclus modelarea bruiajului radar și simularea unor ținte din Taiwan. Reuters a relatat, pe baza informațiilor furnizate de Anthropic, că simularea a ajuns să includă 12 ținte, între care radare de avertizare timpurie, sisteme de rachete Patriot și Tien Kung, baze aeriene și un centru de comandă. Este greu să mai privești un astfel de caz ca pe o simplă demonstrație de „AI care scrie cod”.
Și tocmai aici mi se pare că trebuie să avem grijă la felul în care formulăm problema. Nu AI-ul a decis că vrea să atace Taiwanul. Nu AI-ul a inventat conflictul și nu AI-ul a stabilit că o anumită infrastructură trebuie considerată țintă. Oamenii au făcut asta.
Și poate că aceasta este partea cea mai incomodă: instrumentul poate deveni extraordinar de puternic fără să aibă nicio intenție proprie.
O șurubelniță nu are nevoie să vrea să rănească pe cineva ca să poată fi folosită pentru a răni. Diferența este că AI-ul nu este o șurubelniță. Poate analiza, poate planifica, poate genera cod, poate interpreta informații și, atunci când este conectat la alte sisteme, poate participa la executarea unei strategii.
În raportul său, Anthropic vorbește despre actori de tipuri foarte diferite: grupuri suspectate că au legături cu state, criminali motivați financiar și persoane implicate în activități politice sau ideologice.
Asta contează pentru că arată că problema nu aparține unui singur tip de utilizator. Nu există un singur „răufăcător AI” pe care să-l putem identifica și elimina. Avem o tehnologie generală, accesibilă din ce în ce mai multor oameni, iar capacitatea ei poate fi folosită în direcții complet diferite.
Același model care ajută un cercetător să găsească o soluție pentru o problemă medicală poate fi folosit de altcineva pentru a căuta informații pe care producătorul încearcă să le limiteze. Același model care îi permite unui programator să-și repare codul poate fi folosit într-un atac. Același sistem capabil să analizeze volume uriașe de informații poate fi folosit pentru cercetare sau pentru supraveghere.
Când îi dai AI-ului acces la lume, începe adevărata discuție despre siguranță
Cred că acesta este punctul în care conversația despre AI trebuie să se maturizeze. Am petrecut foarte mult timp discutând despre cât de bine răspunde un model, dacă inventează informații, dacă este mai bun decât alt model la programare sau dacă poate trece un anumit test. Toate acestea contează, însă există un moment în care performanța modelului devine doar una dintre variabile.
Anthropic însuși spune în documentele sale despre siguranță că un AI complet autonom poate fi periculos tocmai pentru că ar presupune ca sistemul să aibă valori benefice, judecată bună și capacitatea de a lua decizii fără verificări umane. Compania lucrează, în paralel, la sisteme automate capabile să detecteze atacuri cibernetice sofisticate care folosesc Claude, inclusiv cu cât mai puțină intervenție umană. Construim AI mai puternic. Apoi construim AI care să supravegheze AI-ul mai puternic.
Încercăm să-i înțelegem comportamentul. Anthropic are o echipă de interpretabilitate dedicată tocmai încercării de a explica de ce modelele fac ceea ce fac, inclusiv în contexte legate de utilizare abuzivă și comportament autonom periculos. Facem red teaming pentru a descoperi ce ar putea face modelele în scenarii ostile. Construim reguli, filtre, sisteme de detectare și politici de utilizare. Toate acestea sunt necesare.
Dar există o întrebare pe care nu o putem evita: cât de multă putere ar trebui să primească un sistem pe care încă încercăm să îl înțelegem?
Pentru că aici se află diferența dintre un AI care este doar foarte inteligent și un AI care poate deveni foarte influent.
Imaginează-ți două sisteme identice. Ambele sunt excelente la programare, cercetare și analiză. Primul poate doar să-ți ofere răspunsuri. Al doilea poate accesa internetul, poate executa cod, poate citi și modifica fișiere, poate trimite mesaje și poate interacționa cu alte servicii.
Care este mai periculos?
Nu trebuie să te gândești prea mult la răspuns. Și tocmai de aceea cred că viitorul AI nu va fi definit numai de întrebarea „cât de inteligent este modelul?”, ci de întrebarea „ce poate atinge modelul?”.
Puterea reală a unui AI va veni din ce în ce mai mult din conexiunile sale. Un model izolat este un lucru. Un model conectat la emailul tău este altceva. Un model conectat la conturile tale financiare este altceva. Un model care poate modifica documente, administra infrastructură, rula cod și lua decizii fără confirmarea ta este deja într-o categorie complet diferită. De aceea, discuția despre permisiuni devine aproape la fel de importantă ca discuția despre inteligență.
Nu mă sperie în mod special ideea că un chatbot va deveni într-o zi suficient de inteligent încât să scrie un program complicat. Mă interesează mai mult ce se întâmplă în ziua în care acel chatbot poate să scrie programul, să îl execute, să observe rezultatul, să decidă ce nu a funcționat, să modifice codul și să încerce din nou fără să mai aștepte de fiecare dată intervenția unui om. Acolo începe autonomia, iar autonomia este ceea ce poate transforma capacitatea în putere.
Poate că întrebarea corectă nu este dacă AI-ul va deveni periculos, ci câtă putere suntem dispuși să-i dăm
Nu cred că raportul Anthropic este un motiv să ne uităm la orice sistem AI ca la o amenințare. Dimpotrivă, faptul că aceste operațiuni au fost detectate și întrerupte arată că există mecanisme prin care companiile pot identifica abuzul și pot reacționa. Anthropic spune că a blocat toate operațiunile prezentate în raport și că a transmis informații autorităților și partenerilor din industrie acolo unde a considerat necesar.
Dar raportul arată și ceva ce nu ar trebui să ignorăm: oamenii încearcă deja să împingă modelele dincolo de rolul de chatbot. Iar pe măsură ce modelele devin mai bune, încercările acestea vor deveni probabil mai sofisticate.
Nu este nevoie să ajungem la scenariul SF în care un AI își dezvoltă propria voință și decide că omenirea este o problemă. Este suficient să avem oameni care vor să fure, să manipuleze, să spioneze, să atace sau să construiască sisteme periculoase și un AI care le poate face munca mai rapid. Asta este, într-un fel, mult mai banal și tocmai de aceea mai greu de ignorat.
Pericolul nu vine neapărat din faptul că AI-ul ar putea avea propriile intenții. Uneori, pericolul vine din faptul că nu are nevoie de intenții proprii pentru a amplifica intențiile altora.
Și aici cred că trebuie schimbată și discuția publică despre inteligența artificială. Ar trebui să vorbim mai puțin despre cât de bine imită omul și mai mult despre ce putere îi oferim atunci când îl conectăm la lumea reală.
Un AI care îți scrie un email nu este același lucru cu un AI care poate trimite emailul fără să te întrebe. Un AI care îți explică un atac informatic nu este același lucru cu unul care poate executa etapele atacului. Un AI care îți analizează informațiile nu este același lucru cu unul care poate colecta singur informațiile, poate decide ce este relevant și poate continua să caute fără supraveghere. Diferența dintre aceste scenarii nu este neapărat inteligența modelului. Este permisiunea. Iar acesta ar putea fi unul dintre cele mai importante cuvinte din viitorul AI: permisiunea.
Cât acces primește? La ce sisteme? Pentru cât timp? Ce poate face fără confirmare? Ce trebuie să ceară unui om? Cine vede ce face? Cine poate opri procesul? Ce se întâmplă dacă greșește? Și, poate cel mai important, ce se întâmplă dacă persoana care îi oferă acces nu are intenții bune? Sunt întrebări mai puțin spectaculoase decât „va deveni AI-ul conștient?”, dar sunt mult mai apropiate de realitate.
În fond, nu avem nevoie de o inteligență artificială care să ne urască pentru a avea o problemă. Avem nevoie doar de una suficient de capabilă, conectată la suficiente instrumente și pusă în mâinile cuiva care știe ce vrea să obțină.