Modelele AI mici contra giganților: când este mai bun un algoritm specializat decât unul care „știe de toate”?

' fill='%23FBBC05' d='M0 37V11l17 13z'/%3e%3cpath clip-path='url(%23b)' fill='%23EA4335' d='M0 11l17 13 7-6.1L48 14V0H0z'/%3e%3cpath clip-path='url(%23b)' fill='%2334A853' d='M0 37l30-23 7.9 1L48 0v48H0z'/%3e%3cpath clip-path='url(%23b)' fill='%234285F4' d='M48 48L17 24l-4-3 35-10z'/%3e%3c/svg%3e)
Un director cere cel mai puternic model AI disponibil, fiind convins că astfel reduce riscul unei alegeri greșite. Echipa tehnică îl conectează la aplicația internă, demonstrația impresionează, iar primele rezultate par să confirme decizia. După câteva săptămâni, apar însă întrebări mai puțin spectaculoase: de ce durează atât de mult clasificarea unui mesaj scurt, cât costă verificarea a mii de documente și era nevoie de un sistem atât de complex pentru a extrage trei informații dintr-un formular? În acel moment, dimensiunea modelului începe să fie privită prin raportare la muncă, nu la prestigiul produsului.
Modelele mici intră în discuție tocmai aici. Pot executa unele sarcini cu resurse mai puține, pot fi adaptate unui proces și pot funcționa în medii unde un model foarte mare este dificil de administrat. Totuși, ideea unui algoritm specializat care învinge un „gigant” are nevoie de precizie: un model mic nu devine automat specialist, iar un model mare nu este condamnat să fie ineficient. Ceea ce contează este potrivirea dintre sistem, date, constrângeri și definiția rezultatului corect.
Dimensiunea și specializarea sunt două lucruri diferite
În cazul modelelor de limbaj, dimensiunea este exprimată frecvent prin numărul parametrilor, adică al valorilor învățate care influențează prelucrarea informației. Acest număr oferă un indiciu despre resurse, dar nu reprezintă un scor universal de inteligență. Arhitectura, datele, antrenarea și modul de utilizare pot schimba substanțial rezultatele. În plus, modelele cu activare selectivă nu folosesc neapărat toți parametrii la fiecare pas, ceea ce complică și mai mult comparația bazată exclusiv pe cifra afișată în nume.
Specializarea descrie altceva: adaptarea la un domeniu sau la un tip de sarcină. Un model relativ mic poate fi generalist, iar un model foarte mare poate fi adaptat pentru o activitate precisă. Există și sisteme care clasifică, detectează sau estimează fără să genereze text conversațional. Pentru identificarea unui tip de document, un asemenea algoritm poate fi mai potrivit decât un asistent care formulează răspunsuri ample. Întrebarea utilă devine ce operațiune trebuie executată și ce fel de rezultat cere aplicația.
Microsoft oferă un exemplu relevant prin Phi-4-Mini, prezentat în raportul tehnic din 2025 ca model cu 3,8 miliarde de parametri. Autorii descriu rezultate competitive pe anumite sarcini de matematică și programare, obținute prin selecția datelor și printr-o rețetă de antrenare care include date sintetice. Rezultatele din raport sunt legate de evaluările respective; ele nu demonstrează că modelul depășește orice sistem mai mare în orice conversație. Exemplul arată însă că dimensiunea și performanța nu cresc într-o relație simplă și uniformă.
Într-o firmă românească, un caz potrivit ar putea fi identificarea motivului principal din solicitările către suport: facturare, livrare, retur sau problemă tehnică. Dacă sarcina este bine delimitată și exemplele acoperă activitatea reală, un sistem compact poate avea un avantaj practic. Dacă aceeași cerere presupune interpretarea unui contract, compararea unor politici și formularea unei soluții pentru o situație nouă, dificultatea se schimbă. Simplul fapt că ambele operațiuni pornesc de la text nu le face echivalente.
De unde vin avantajele și unde apar limitele unui model compact
Un sistem mai mic poate reduce resursele necesare stocării și execuției, dar economia reală depinde de implementare. Dacă același volum de cereri poate fi procesat pe un echipament mai accesibil sau mai aproape de utilizator, compania câștigă opțiuni. Pe de altă parte, o aplicație care așteaptă răspunsuri foarte lungi sau păstrează conversații ample poate solicita multă memorie chiar și cu un model compact. Dimensiunea inițială este doar una dintre componentele costului de funcționare.
Cuantizarea reduce precizia numerică folosită pentru reprezentarea anumitor valori și poate micșora amprenta modelului. Ca ordin de mărime pur aritmetic, patru miliarde de valori reprezentate fiecare pe patru biți înseamnă aproximativ două miliarde de octeți pentru acele valori. Aceasta nu este memoria totală necesară aplicației: se adaugă alte structuri, informațiile intermediare și resursele programului. Calculul ajută la înțelegerea direcției, dar nu trebuie transformat într-o promisiune că orice laptop cu acel spațiu liber va rula confortabil modelul.
Viteza trebuie măsurată pe activitatea concretă. Un model mai mic poate genera rapid, însă un proces care îl apelează repetat, îi cere să reformuleze și trimite frecvent rezultatele către alt sistem poate ajunge mai lent decât o soluție mai puternică utilizată o singură dată. Contează și încărcarea simultană, lungimea cererilor și momentul în care răspunsul devine util. Pentru un angajat, timpul până la un rezultat corect este mai relevant decât viteza unei secvențe de text generată în laborator.
Limitele sunt la fel de importante ca avantajele. Fișa Microsoft pentru Phi-4-mini-instruct discută limitări de cunoaștere factuală, comportamente nesigure și diferențe între utilizări, iar evaluările de siguranță arată inclusiv posibilitatea inventării unor nume de funcții sau adrese. Aceste observații nu sunt un motiv de a respinge categoria, ci de a evita presupunerea că un model compact este previzibil prin simpla sa dimensiune. Dacă aplicația trebuie să interacționeze cu sisteme reale, validarea comenzilor rămâne o responsabilitate separată.
Cum arată o comparație corectă pentru activitatea unei companii
O comparație utilă începe prin definirea greșelii. Pentru un instrument care extrage o dată de scadență, eroarea poate fi o valoare incorectă sau absența unui câmp obligatoriu. Pentru clasificarea mesajelor, poate conta mai mult rata la care solicitările urgente sunt trimise în categoria greșită decât procentul general de răspunsuri corecte. Fără această definiție, o medie frumoasă poate ascunde exact problema care produce cele mai mari costuri. Modelul trebuie evaluat în raport cu consecințele sarcinii.
Setul de test ar trebui să includă exemplele pe care colegii le întâlnesc într-o zi dificilă, nu doar documentele bine redactate. În română, asta poate însemna lipsa diacriticelor, abrevieri, termeni amestecați cu engleza și exprimări care presupun context intern. Dacă pregătești evaluarea, păstrează separat exemplele folosite pentru adaptare și cele utilizate pentru verificarea finală. Altfel, există riscul ca sistemul să pară competent fiindcă a întâlnit deja tiparele exacte pe care este examinat.
Merită separate trei moduri de îmbunătățire. Instrucțiunile mai clare schimbă felul în care ceri rezultatul; furnizarea unor documente relevante îi oferă modelului context la momentul utilizării; adaptarea prin antrenare modifică parametrii. Aceste metode rezolvă probleme diferite. Dacă lipsește o regulă recentă dintr-un manual, poate fi mai potrivit să furnizezi sursa actualizată decât să presupui că un model specializat trebuie reantrenat după fiecare modificare. Dacă problema este un tipar stabil de clasificare, adaptarea poate avea alt sens.
Niciunul dintre aceste mecanisme nu oferă automat adevărul. Un model care consultă documente poate selecta pasajul greșit sau poate interpreta greșit o excepție. Un model adaptat poate reproduce erori din exemplele aprobate. Pentru o sarcină importantă, testează și capacitatea sistemului de a recunoaște lipsa informației, de a cere lămuriri și de a trimite cazul mai departe. Un răspuns care spune corect că nu poate decide poate fi mai valoros decât o explicație fluentă care ascunde o presupunere.
În evaluare trebuie inclus și timpul oamenilor. Dacă un model mai ieftin produce multe rezultate aproape corecte, corectarea lor poate consuma mai mult decât diferența economisită la procesare. Situația inversă este la fel de posibilă: un sistem simplu, care returnează un rezultat scurt și verificabil, poate reduce munca fără să impresioneze într-o demonstrație publică. Compară soluțiile pe același volum, cu aceleași reguli și cu verificatori care nu știu dinainte ce model a generat fiecare răspuns.
De ce viitorul poate aparține echipelor de modele, nu unui singur câștigător
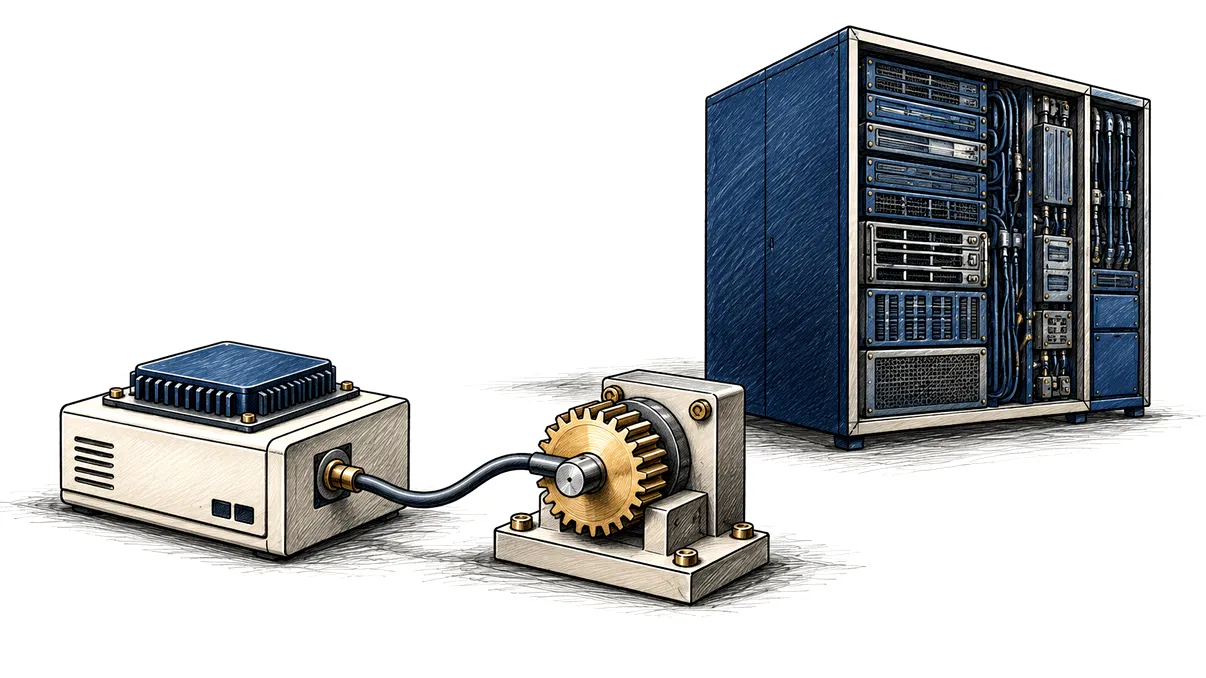
Pentru multe procese, o combinație este mai realistă decât alegerea exclusivă a unui model mic sau mare. Un sistem compact poate prelua cererile uzuale, iar cazurile dificile pot ajunge la un model mai capabil sau la un specialist. Arhitectura are sens dacă escaladarea este bine definită și dacă datele pot urma acel traseu. Altfel, economiile aparent simple se transformă într-un lanț greu de urmărit, în care nimeni nu știe exact cine a validat rezultatul final.
Există deja cercetare și produse pentru selecția automată între modele. RouteLLM studiază alegerea pe baza datelor de preferință, urmărind un compromis între cost și calitate. Cercetarea nu oferă o rețetă universală pentru orice firmă, dar susține ideea că aceeași aplicație poate distribui cereri diferite către sisteme diferite. Un astfel de mecanism trebuie verificat pe propriile sarcini, pentru că dificultatea percepută de un router nu coincide obligatoriu cu riscul real al unei decizii de afaceri.
O cerere aparent simplă poate fi importantă. „Aprobă plata” conține puține cuvinte, însă consecințele sunt diferite de cele ale unui rezumat lung pregătit pentru uz intern. De aceea, modelul ales și drepturile acordate trebuie evaluate separat. Un algoritm specializat poate identifica foarte bine informații într-o factură fără să primească permisiunea de a autoriza transferul. Încrederea într-o performanță măsurată nu trebuie extinsă automat la alte operațiuni pe care sistemul nu a fost verificat să le execute.
Mai apare și costul întreținerii. Mai multe modele înseamnă versiuni, licențe, dependențe și teste distincte. Dacă fiecare departament introduce propriul specialist digital fără o evidență comună, firma poate ajunge la o infrastructură fragmentată, greu de actualizat. Pentru o echipă cu resurse limitate, un serviciu administrat bine poate fi preferabil unei colecții de modele locale. Alegerea potrivită depinde de capacitatea organizației de a susține soluția după lansare, când interesul pentru proiect scade și problemele rămân.
Un model mic este mai bun atunci când îndeplinește sarcina la nivelul cerut, cu un cost total și un control potrivite contextului. Un model mare își justifică resursele atunci când capacitatea suplimentară rezolvă dificultăți care contează în activitatea reală. Pentru colegul care așteaptă rezultatul, această competiție se traduce foarte simplu: instrumentul trebuie să îl ajute fără să îi lase o muncă invizibilă de verificare. Valoarea se vede în procesul care funcționează, nu în dimensiunea sistemului ales pentru a-l susține.