Problemele Microsoft și succesiunea evenimentelor care au pus comunicațiile globale pe butuci. Outlook și Teams au fost doar începutul dezastrului

' fill='%23FBBC05' d='M0 37V11l17 13z'/%3e%3cpath clip-path='url(%23b)' fill='%23EA4335' d='M0 11l17 13 7-6.1L48 14V0H0z'/%3e%3cpath clip-path='url(%23b)' fill='%2334A853' d='M0 37l30-23 7.9 1L48 0v48H0z'/%3e%3cpath clip-path='url(%23b)' fill='%234285F4' d='M48 48L17 24l-4-3 35-10z'/%3e%3c/svg%3e)
În 2026, am ajuns să tratăm disponibilitatea serviciilor online ca pe o certitudine, aproape la fel de firească precum electricitatea care alimentează calculatorul sau semnalul telefonului mobil. Ne-am obișnuit să credem că un email trimis ajunge la destinație, că o întâlnire programată în calendar va apărea automat în Teams și că documentele importante ale unei companii vor fi accesibile indiferent de locul în care se află angajații. Numai că, în ultimele 24 de ore, una dintre cele mai mari companii de tehnologie din lume ne-a demonstrat cât de fragilă este infrastructura pe care am construit această încredere.
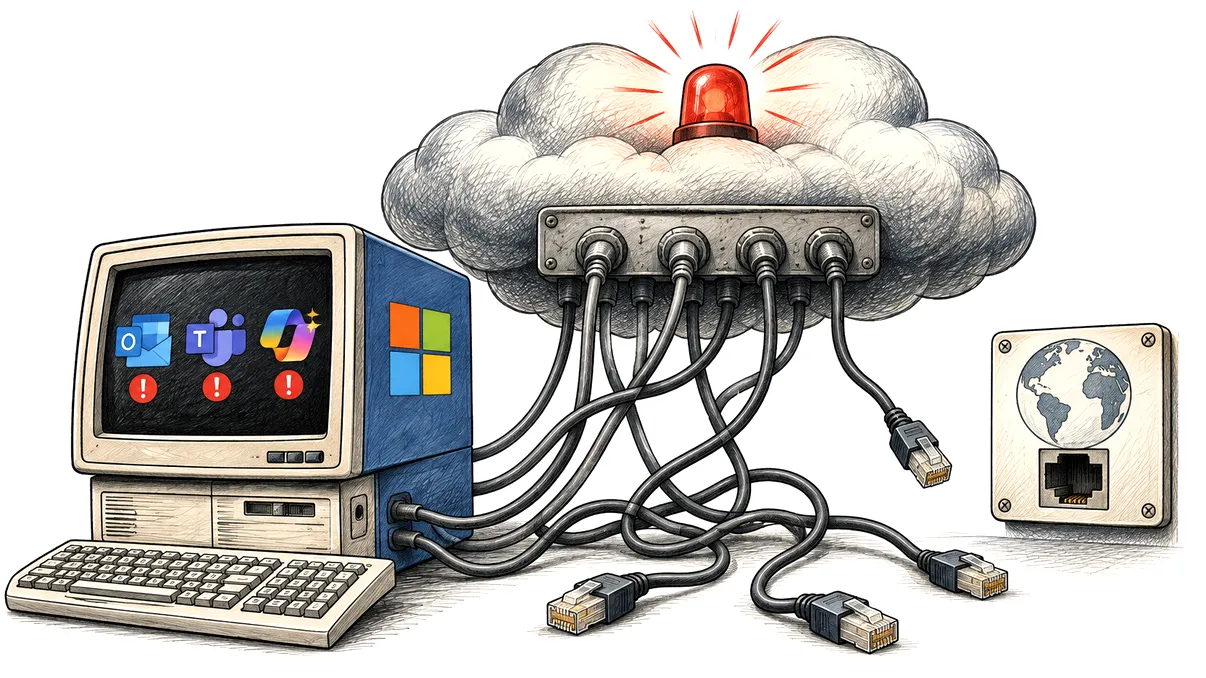
Totul a început cu Microsoft Outlook și probleme de acces la emailuri. Au urmat Teams, Copilot și o listă tot mai lungă de servicii Microsoft 365, până când incidentul a depășit granițele unei defecțiuni informatice obișnuite. Instituții guvernamentale au întâmpinat dificultăți de comunicare, organizații medicale au activat proceduri alternative, companii aeriene au rămas fără anumite canale de asistență, iar unele instituții financiare au fost nevoite să recurgă la metode de lucru care păreau abandonate cu zeci de ani în urmă.
Vineri, 13 noiembrie 2026, consecințele continuă să fie resimțite pe mai multe continente. Microsoft raportează progrese în restabilirea serviciilor, însă recuperarea este graduală, iar funcționarea normală nu fusese încă restabilită integral la momentul redactării. Dincolo de explicațiile tehnice, poate cea mai tulburătoare concluzie este că o problemă apărută în infrastructura unui singur furnizor a devenit, în câteva ore, problema unei bune părți a lumii conectate.
Cum a început dezastrul Microsoft și de ce primele încercări de remediere au eșuat
Cronologia oficială a incidentului arată că problemele Exchange Online au început joi, 12 noiembrie, la ora 16:17 UTC, adică 18:17 în România. Inițial, Microsoft a investigat dificultățile utilizatorilor din America de Nord și de Sud care nu își mai puteau accesa căsuțele poștale, însă amploarea incidentului avea să devină evidentă foarte repede. La ora 18:26 UTC, echivalentul orei 20:26 în România, compania a înregistrat un incident distinct pentru afectarea mai multor servicii Microsoft 365. Nu mai era vorba doar despre Outlook.
Platforma Downdetector a început să înregistreze creșteri spectaculoase ale raportărilor. În Statele Unite, numărul sesizărilor pentru Outlook a ajuns la aproximativ 130.000 în apropierea vârfului incidentului, iar într-un interval de aproximativ o oră au fost semnalate probleme din 74 de țări și teritorii. Cifrele sunt importante pentru a înțelege răspândirea defecțiunilor, dar trebuie interpretate corect: o raportare nu înseamnă neapărat un utilizator unic, iar numărul celor care nu au putut lucra nu poate fi dedus direct din statisticile Downdetector.
Explicația inițială oferită de Microsoft făcea referire la o încărcare neobișnuit de mare a infrastructurii sale. Ulterior, inginerii au constatat că nu o creștere firească a traficului era responsabilă pentru situație, ci faptul că mai multe servere deveniseră indisponibile în mod neașteptat. Cele rămase active trebuiau să gestioneze un volum de solicitări pentru care infrastructura disponibilă nu mai avea suficientă capacitate. Un asemenea dezechilibru poate transforma o defecțiune localizată într-o problemă cu efecte asupra întregului sistem.
Microsoft a început să redistribuie conexiunile, să oprească temporar implementările de software și să repornească serverele afectate. Problema era însă mai complicată. Unele servere reveneau online și păreau stabile pentru o perioadă, numai pentru a înceta din nou să răspundă după reluarea traficului real. Cu alte cuvinte, repornirea infrastructurii nu rezolva mecanismul care provocase indisponibilitatea ei.

În cursul nopții de joi spre vineri, Microsoft a recunoscut că măsurile aplicate nu produceau rezultatele anticipate. Au fost investigate tipurile de solicitări care suprasolicitau un proces esențial al serverelor, a fost limitat selectiv traficul și au fost izolate anumite segmente de infrastructură pentru repornire și testare. Inginerii au analizat inclusiv reconstruirea unor servere folosind configurații software anterioare.
Vorbim, așadar, despre un incident care a depășit 12 ore și în care fiecare încercare de remediere trebuia evaluată cu atenție. Dacă infrastructura era readusă prea repede la capacitate normală, riscul era ca aceleași servere să cedeze din nou, prelungind indisponibilitatea serviciilor.
Outlook și Teams au fost doar începutul. Lista serviciilor afectate dezvăluie amploarea problemei
Exchange Online reprezintă una dintre componentele fundamentale ale ecosistemului Microsoft destinat companiilor. Nu este doar serviciul prin care Outlook trimite și primește emailuri, ci și infrastructura care gestionează calendare, contacte și schimburi de informații utilizate de numeroase alte aplicații. În momentul în care această componentă nu mai funcționează corect, problemele pot apărea în aplicații care, la prima vedere, nu au nicio legătură directă cu emailul.
În Outlook, utilizatorii au raportat imposibilitatea de a accesa mesajele, erori de conectare prin browser, aplicațiile desktop sau dispozitivele mobile și întârzieri în livrarea corespondenței. Microsoft a confirmat afectarea conexiunilor MAPI, Exchange ActiveSync și REST, alături de interfața web. Pentru o companie care își coordonează activitatea între mai multe țări, o corespondență care întârzie câteva ore poate însemna documente neaprobate, comenzi neconfirmate sau decizii amânate.
Microsoft Teams a fost afectat într-un mod mai nuanțat decât sugerează unele dintre relatările inițiale. Conform companiei, funcțiile esențiale de mesagerie, apelurile, întâlnirile online și canalele obișnuite au rămas în mare parte operaționale. În schimb, programarea întâlnirilor, invitațiile, calendarele, organizarea evenimentelor virtuale și anumite funcții administrative dependente de Exchange Online au întâmpinat erori. Pentru utilizatorul care încearcă să organizeze o ședință importantă, distincția tehnică dintre o aplicație complet indisponibilă și o funcție critică blocată nu schimbă prea mult rezultatul practic.
Au urmat dificultăți asociate cu Microsoft 365 Copilot, unde utilizatorii au putut întâmpina probleme la încărcarea conversațiilor sau la obținerea răspunsurilor, inclusiv atunci când asistentul trebuia să consulte emailuri, documente și calendare. SharePoint Online a înregistrat probleme la anumite funcții de partajare externă și la componentele dependente de email, deși accesul direct la fișierele stocate a rămas funcțional. Au existat și raportări privind OneDrive, însă acestea nu demonstrează că întregul serviciu de stocare a devenit indisponibil la nivel mondial.
Lista oficială s-a extins și către Microsoft Planner, To Do, Intune, Power Apps, Power BI, Microsoft Fabric, Universal Print și Windows 365, unde au fost afectate funcții specifice sau anumite categorii de utilizatori. Microsoft Graph, interfața prin care aplicațiile și automatizările accesează informații din serviciile Microsoft, a înregistrat la rândul său probleme pentru solicitările care necesitau date Exchange Online.
Poate și mai îngrijorătoare este afectarea instrumentelor de securitate și administrare. Microsoft Defender XDR, Defender for Office 365 și Purview au înregistrat dificultăți de acces, întârzieri sau erori în anumite operațiuni. Printre funcțiile vizate s-au numărat analiza incidentelor, verificarea unor linkuri, gestionarea mesajelor aflate în carantină și aplicarea unor politici de protecție a informațiilor. Asta nu înseamnă că toate mecanismele de securitate Microsoft au încetat să funcționeze, ci că o parte dintre instrumentele pe care administratorii se bazează pentru a verifica și gestiona amenințările au devenit mai puțin fiabile tocmai în timpul unei crize.
Efectele s-au propagat inclusiv dincolo de Microsoft. OpenAI și Anthropic au confirmat probleme cu instrumentele prin care serviciile lor de inteligență artificială se conectează la Microsoft 365. În cazul ChatGPT, au fost afectate anumite conexiuni și operațiuni asociate integrărilor Microsoft, nu întreaga platformă. Anthropic a raportat erori în accesarea emailurilor, calendarelor și funcțiilor de căutare, inclusiv prin Claude for Outlook. Este un exemplu relevant al dependențelor tot mai complicate dintre sistemele de inteligență artificială și infrastructura cloud a companiilor.
În paralel, au fost consemnate și probleme la alte componente Microsoft, inclusiv un incident separat care afecta deschiderea sau crearea unor documente în Word pentru web, atribuit unei modificări de configurare și unei incompatibilități cu anumite browsere. Nu există însă motive să presupunem că toate erorile raportate în această perioadă, inclusiv cele asociate cu Azure sau Microsoft Store, au avut aceeași cauză. Diferența dintre o pană confirmată și o suprapunere de raportări este esențială.
De la spitale și poliție la companii aeriene și burse. Consecințele reale ale unei lumi fără email
În Marea Britanie, amploarea incidentului a devenit imposibil de ignorat atunci când anumite forțe de poliție au început să anunțe că nu mai puteau primi sesizările transmise prin formularele online. Metropolitan Police și alte structuri au întâmpinat dificultăți de comunicare, în timp ce Dorset Police, South Wales Police și Dyfed-Powys Police au îndrumat cetățenii către canalele telefonice disponibile. Sistemele pentru apelurile de urgență nu au fost declarate indisponibile, dar situația a arătat că o defecțiune în serviciile comerciale de email poate ajunge să afecteze inclusiv felul în care oamenii comunică cu autoritățile.
Consecințele din sistemul medical au fost cel puțin la fel de îngrijorătoare. Mai multe organizații din cadrul NHS, serviciul public de sănătate britanic, au semnalat dificultăți de utilizare a Outlook și Teams. Unele unități au cerut pacienților să telefoneze în loc să trimită emailuri, în timp ce alte organizații au apelat la proceduri alternative, inclusiv evidențe pe hârtie. Asociațiile profesionale au avertizat că pot apărea întârzieri în procesarea unor rețete. Este important de precizat că nu a fost anunțată o oprire generalizată a asistenței medicale, iar mai multe unități au comunicat că programările continuă normal.
Totuși, imaginea unei organizații medicale moderne care trebuie să revină la hârtie pentru a menține continuitatea activității spune mai multe despre vulnerabilitatea sistemelor digitale decât orice comunicat corporativ. Un email care nu ajunge la timp poate părea un inconvenient minor până în momentul în care în spatele lui se află un pacient, o solicitare administrativă urgentă sau o informație de care depinde următoarea decizie.
În Asia, efectele au fost la fel de concrete. Agenția guvernamentală de tehnologie din Singapore a confirmat probleme cu emailurile instituțiilor publice. În Japonia, autoritățile au recunoscut afectarea infrastructurii informatice guvernamentale și au activat mijloace alternative de comunicare. Curtea Supremă din Filipine a semnalat dificultăți în anumite operațiuni, inclusiv în transmiterea răspunsurilor prin email. În Australia, printre organizațiile afectate s-au numărat poliția federală și structuri din domeniul securității.
Industria transporturilor a avut propriile probleme. Air India, IndiGo și Akasa Air au raportat dificultăți legate de canalele de asistență prin email. Air India a redirecționat temporar corespondența pentru a păstra comunicarea cu pasagerii, în timp ce IndiGo a anunțat că alte modalități de contact rămân disponibile. Companiile au precizat că operațiunile de zbor nu au fost afectate, detaliu important într-un context în care relatările despre o pană globală pot crea impresia eronată că avioanele au rămas la sol.
În lumea financiară, consecințele au depășit însă sfera inconvenientelor. Reuters relatează că operatorul bursier european Euronext a întâmpinat probleme cu emailurile, compania britanică Aviva a activat soluții de rezervă pentru comunicările financiare, iar grupul danez de transport maritim Maersk și-a avertizat clienții cu privire la posibile întârzieri ale actualizărilor. În Statele Unite, Workhorse Group și-a reprogramat prezentarea rezultatelor financiare, iar grupul elvețian Richemont a întârziat temporar publicarea rezultatelor semestriale.
Cel mai grăitor exemplu vine însă din Taiwan, unde, potrivit Reuters, o companie financiară a recurs la fax pentru confirmarea tranzacțiilor, iar o altă operațiune de răscumpărare a unor obligațiuni a fost anulată. Într-un ecosistem financiar care investește miliarde în automatizare, tranzacționare digitală și infrastructură performantă, faxul a redevenit o soluție practică de continuitate. Nu ca exercițiu nostalgic, ci pentru că anumite mecanisme moderne de comunicare nu mai erau disponibile.
Nici România nu a fost ocolită. Joi seară au început să apară raportări locale, urmate de un nou val vineri dimineață. Potrivit datelor Downdetector consultate de Economedia, în cursul dimineții de 13 noiembrie existau 342 de sesizări pentru Outlook, 168 pentru Microsoft 365 și 39 pentru Teams. Acestea reprezintă doar raportările înregistrate la momentul respectiv, nu numărul real al utilizatorilor afectați. Nu există, deocamdată, o evaluare publică verificată a pierderilor economice produse în România de incident.
Microsoft repară infrastructura, dar cine repară încrederea într-un internet dependent de câțiva giganți
Vineri, 13 noiembrie, Microsoft a început să raporteze rezultate mai încurajatoare după aplicarea unor modificări asupra unei componente implicate în autentificare și rutare. La ora 12:00 UTC, adică 14:00 în România, compania anunța îmbunătățiri ale disponibilității serviciilor și livrării emailurilor în Europa, o situație relativ mai stabilă în Japonia și progrese în America de Nord. În actualizarea de la 12:18 UTC, Microsoft confirma recuperarea unor segmente de infrastructură din regiunea Asia-Pacific, dar avertiza că utilizatorii pot întâmpina în continuare probleme intermitente.
Pentru a reduce riscul pierderii corespondenței întârziate, Microsoft a extins la 48 de ore intervalul de așteptare aplicat mesajelor din cozi. Este o măsură de protecție, nu o garanție că toate emailurile vor ajunge imediat la destinație. Recuperarea serviciilor trebuie urmată și de procesarea mesajelor acumulate, ceea ce înseamnă că efectele incidentului pot persista chiar și după dispariția erorilor de conectare.
Compania susține că nu are dovezi privind existența unei activități malițioase care să fi provocat incidentul. Ministrul australian Tony Burke a relatat că reprezentanții Microsoft au comparat situația, din perspectiva naturii tehnice a problemei, cu pana CrowdStrike din 2024, când o actualizare defectuoasă a produs perturbări majore în întreaga lume. Asta nu confirmă însă o cauză identică pentru incidentul actual. Microsoft nu a publicat încă analiza tehnică definitivă și a promis un raport ulterior în care va explica originea defecțiunii și măsurile luate pentru prevenirea repetării ei.
Din perspectiva dimensiunii economice, este prematur să vorbim despre un total credibil al pierderilor globale. Microsoft anunțase anterior peste 450 de milioane de abonamente comerciale Microsoft 365 plătite, însă această cifră nu trebuie confundată cu numărul persoanelor afectate de pană. Reuters a consemnat și o scădere de aproximativ 1,7% a acțiunilor Microsoft înaintea deschiderii bursei americane, dar nici această evoluție nu reprezintă un calcul direct al prejudiciilor produse de incident.
Problema fundamentală este alta. Microsoft nu vinde doar aplicații, ci infrastructura pe care numeroase companii și instituții au ajuns să își construiască activitatea zilnică. Emailul, colaborarea, administrarea dispozitivelor, securitatea, automatizările și inteligența artificială pot părea servicii distincte, dar dependența lor de aceleași componente tehnice creează puncte comune de vulnerabilitate. Iar când unul dintre acestea cedează, soluțiile aparent independente pot începe să se defecteze în lanț.
Incidentul actual vine după alte probleme Microsoft 365 în ianuarie 2026 și după o întrerupere Azure în luna octombrie, readucând în discuție riscul concentrării infrastructurii digitale în mâinile câtorva furnizori globali. Nu înseamnă că serviciile cloud sunt fundamental nesigure sau că infrastructura locală ar fi automat superioară. Înseamnă, mai degrabă, că disponibilitatea promisă contractual nu poate înlocui planurile reale de continuitate, canalele alternative de comunicare și evaluarea dependențelor tehnice pe care organizațiile le acumulează.
Pentru România, unde digitalizarea administrației, a sistemului medical și a mediului privat este prezentată frecvent drept soluția aproape universală pentru eficiență, evenimentele din 12 și 13 noiembrie ar trebui să reprezinte un avertisment. Digitalizarea fără redundanță și fără proceduri pentru situațiile în care furnizorul principal nu mai răspunde poate transforma rapid eficiența într-o vulnerabilitate greu de administrat.
Poate cel mai neliniștitor aspect al întregii situații este că nu a fost nevoie de un atac informatic confirmat, de un dezastru natural sau de distrugerea vreunui centru de date pentru ca instituții publice, companii financiare și organizații medicale de pe continente diferite să descopere că nu mai pot comunica normal. A fost suficient ca o componentă critică a infrastructurii Microsoft să înceapă să funcționeze defectuos.
Internetul nu s-a oprit. Dar o parte importantă dintre mecanismele prin care lumea modernă își organizează activitatea au devenit, pentru ore întregi, nesigure sau indisponibile. Iar faptul că până și unele dintre cele mai sofisticate organizații financiare ale planetei au fost nevoite să revină la fax ar trebui să ne spună ceva despre cât de mult am confundat confortul tehnologic cu reziliența.